0 定义
从六月份开始,loop engineering这个词逐渐成为agent领域的当红炸子鸡,目前我找到的初始的系统性的介绍这个理念的blog是:Loop Engineering,他提到:“循环工程是指用设计系统来代替你来引导智能体,而不是由你来执行指令。 这里的循环可以理解为一个递归目标,你定义一个目标,人工智能会迭代执行直到完成。”,其实有点类似 claude code 的 /goal 模式,之前我一直想去区分goal和loop的区别,但看了anthropic的blog后,其实没必要去区分,本质上都是loops。
loop engineering和之前所说的harness engineering之类的有什么联系吗,个人感觉理念上没有什么太大的区别,之前使用harness搭建的一个agent workflow,其实本质上也是满足loop的思想的,真的要仔细区分的话,网络上有人这样分类(第12章:Loop Engineering —— 从提示 Agent 到设计循环 —— 《AI时代的软件工程》):
Loop Engineering (谁提示 Agent)
  │
  └── Harness Engineering (Agent 的运行环境)
        │
        └── 方法论层 (Agent 怎么做事)
              │   Skills / SDD / Ralph Loop / gstack / Goal Workflow / autoresearch
              │
              └── 项目层 (做什么事)
                    goscapy / Web 应用 / 微服务...
用 Osmani 的话说:Harness 让一个 Agent 安全运行,Loop 让一群 Agent 自己跑起来。
这里补充一句更严谨的区分:harness 更偏单个 agent 的运行环境,loop 更偏触发、分发、验证、状态和持续运行的系统层。但从我自己的使用体验看,很多 harness 搭出来的 agent workflow,本质上也已经在满足 loop 的思想,所以不必过度纠结名词边界。
Claude Code 团队给出的loop定义更工程化:agent 重复执行若干工作周期,直到某个停止条件被满足。重复执行对于agent来说很容易做到,难的是判断什么时候该停。在传统自动化里,循环通常由明确的程序条件控制,例如队列为空、测试通过、时间到达。在 agent 场景里,如果停止条件只是“模型觉得差不多了”,就会引入主观判断。Claude Code 团队强调 /goal、验证技能、代码审查和 token 边界,本质上都是为了把停止条件从模型的模糊感觉,变成可被检查的工程事实。不是所有任务都需要复杂 loop。简单任务用简单交互完成即可。复杂 loop 应该是为了解决“单轮不够、人工成为瓶颈、任务有可验证边界”这些具体问题,而不是为了追求 agent 化而 agent 化。
1 loop的组成
loops字面意思就是循环,循环的基础要素个人理解有两个:generation (workflow) & verification。在实际的任务中,设计一个loop,首先要想好这个场景的业务逻辑是什么,搭建出业务的workflow,也就是之前作为人类的工作流程沉淀成agent的执行过程。此外,最重要的是verification gate,类似于评判这个工作完成的标准,这个验证的过程类似之前agent一直强调的ReAct中的observation,观察周围环境其实进一步演化就是看验证器的返回是否满足要求,然后再去reasoning→action。
补充一下:如果是 long-running loop,还需要显式的 state / memory。也就是要记录已经处理过什么、下一步是什么、失败在哪里。否则 loop 很容易重复处理同一个反馈,或者在会话恢复、上下文压缩后丢失进度。
osmani给出了他认为loop的组成部分:
- Automations
- Worktrees
- Skills
- Plugins and connectors
- Sub-agents
- State / memory
这些部分在codex或者cc中都是有对应的实现,
- 例如Claude Code 是通过调度和钩子实现的。你可以使用
/loop定时运行提示符或命令,可以安排 cron 任务,可以使用钩子在代理生命周期的特定节点执行 shell 命令,或者如果你希望它在你合上笔记本电脑后继续运行,可以将整个流程推送到 GitHub Actions。 - worktrees不必多说,不同的agent处理同一个repo的时候需要互相隔离。
- 关于skill,osmani在文中提到:the skill is the authoring format and a plugin is how you ship it, When you want to share a skill across repos or bundle a few together you package them as a plugin,也就是说多个skill可以打包成一个plugin,然后发布出去,便于在不同repo & 场景下使用;
- plugin & connectors这部分其实是为了loop更好的执行,例如在github上编辑一个项目时,需要创建issue或者pr,这时候需要使用gh api or mcp。
- 子代理现在应用的非常广泛了,通常按照explore → implement → verify 这种形式去构建sub agent。
- Claude Code 的
/goal命令的底层工作原理:由一个全新的模型来判断循环是否结束,而不是由之前执行工作的模型来判断,这种创建者和检查者的分离机制也应用到了停止条件本身。甚至可以在claude code中使用codex:https://github.com/openai/codex-plugin-cc
- Claude Code 的
这里需要注意一个边界:/goal 的 evaluator 不会独立跑命令或读文件,它只能根据对话里已经出现的证据判断目标是否达成。所以目标最好写成可以被 transcript 证明的形式,比如某个测试命令退出码为 0、某个队列为空、某个检查项完成。
2 loop的分类
为了避免几类 loop 混在一起,可以先看这个对照:
| 类型 | 触发条件 | 停止条件 | 适合任务 | 主要风险 |
|---|---|---|---|---|
| Turn-based loop | 用户发起一次 prompt | agent 给出最终回答,或者用户停止 | 日常问答、代码修改、一次性排查 | 验证依赖用户记忆 |
| Goal-based loop | 上一轮结束后自动继续 | evaluator 判断目标达成,或达到轮数/时间上限 | 有明确验收标准的多轮任务 | 目标不可测会导致空转 |
| Time-based loop | 时间间隔或计划任务 | 用户停止、任务过期,或 agent 判断无需继续 | 轮询 CI、PR、部署状态 | 过度轮询浪费 token |
| Proactive loop | 事件、计划、API 或外部系统触发 | 每个任务的目标完成,routine 被关闭,或治理规则拦截 | issue triage、依赖升级、告警处理 | 权限、成本和质量治理复杂 |
(1) Turn-based loops
用户发出提示,Claude 读取上下文、执行动作、检查结果、必要时重复,然后返回它认为完成的结果。这个循环由用户手动触发,也由 Claude 自己判断何时结束或何时需要更多上下文。Claude 会读代码、修改代码、跑测试,然后交还结果,用户再检查并决定下一步。这里的风险是,验证往往依赖用户手工补位。如果用户每次都要提醒“打开浏览器检查”“看控制台”“截图对比”,那么 loop 虽然有 agent 参与,但质量门槛仍然外置在人的记忆里。
改进方式也很简单,把人工验证步骤写进 SKILL.md。skill 不是为了让 prompt 变长,而是把团队的“完成定义”和“检查动作”变成可复用的程序化习惯。例如 UI 改动不能只看编辑成功,还要启动服务、交互验证、截图、检查控制台、跑性能审计。这样 turn-based loop 仍然简单,但质量边界更清楚。
(2) Goal-based loop
goal-based loop 用 /goal 扩展 agent 的迭代时间。它适合单轮无法完成、但完成标准可以被明确验证的任务。停止条件是目标达成,或者达到用户设定的最大轮数。这类 loop 的价值在于:用户不再需要每轮手动判断“继续还是停止”,系统会用目标条件约束 agent。一个 evaluator model 会检查条件,如果不满足就把 Claude 送回继续工作,直到达标或达到轮数上限。
这里的设计重点是目标要可测。比如“把 Lighthouse 分数提升到 90 以上,最多尝试 5 次”比“把首页优化一下”更适合 /goal。前者有量化指标、清晰停止点和成本上限;后者会让 agent 在“还可以更好”的开放空间里游走。
对工程团队来说,/goal 最适合三类任务:
- 有自动化测试、评分或静态检查的任务。
- 有明确验收标准但需要多次尝试的修复。
- 可以容忍有限探索,但不能无限消耗的优化工作。
(3) Time-based loop
time-based loop 用 /loop 或 /schedule 解决“任务本身会反复出现”的问题。它的触发条件不是用户当下发 prompt,而是时间间隔或计划任务。文章给的典型场景包括每天总结 Slack 消息,或者定期检查 PR 是否收到 review、CI 是否失败。这些任务共同点是:工作模式相同,输入随时间变化;或者外部系统状态会变化,需要 agent 定期查看并响应。文章也提醒不要频繁轮询。更长间隔或基于事件触发通常更省 token,也更接近真实需求。如果外部系统每小时才变化一次,每 5 分钟检查就是浪费。
- 这里有一个重要边界:
/loop在本机运行,机器关掉就停止;/schedule则把循环迁移到云端例行任务。这不是单纯部署位置差异,而是责任模型变化。本机 loop 更像个人辅助,云端 schedule 更像持续运行的自动化流程,需要更谨慎地设置频率、权限和失败处理。
cc的loop终止条件是no tool calls:
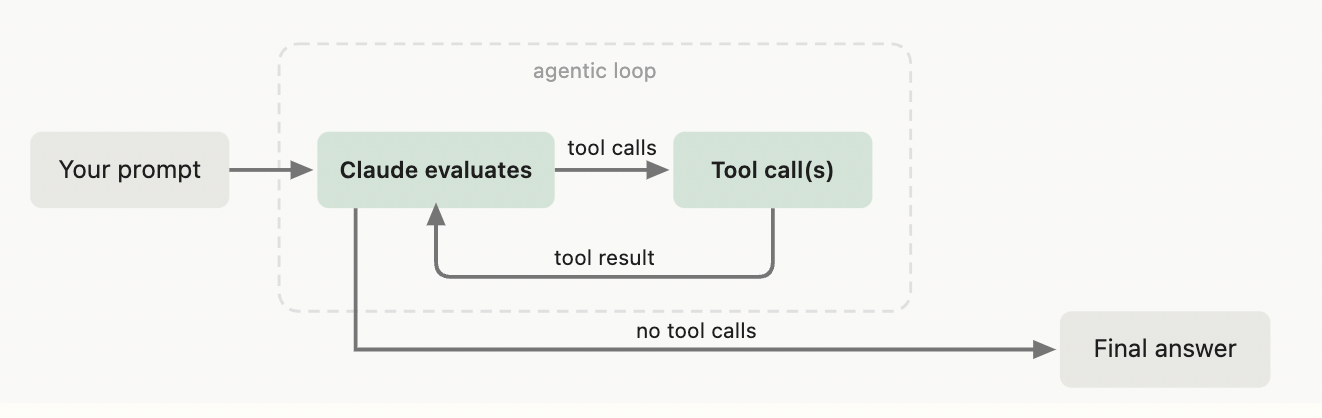
更准确地说,这里的“no tool calls”对应 Claude Code Agent SDK / turn-based inner loop:Claude 评估、调用工具、接收工具结果并继续,直到某一轮没有 tool call 才输出最终答案。它不是 /loop 这种 time-based scheduled task 的停止条件。
这种模式很适合修复已知问题,例如cc官方给出的例子:“修复 auth.ts 中失败的测试”,前几个turn可能会使用bash read write等tool,直到最后一次输出text-only response,这个时候便认为cc完成了这个loop。
(4) Proactive loops
proactive loop 是最高复杂度的形态:它由事件或计划触发,不需要人实时在场;每个任务有自己的目标,整个 routine 一直运行直到被关闭。适用场景包括 bug report、issue triage、迁移、依赖升级等“持续流入、结构相对稳定”的工作。它可以是多个 Claude Code 原语的组合:/schedule 负责定期检查,/goal 定义完成标准,dynamic workflows 负责把 triage、修复、review 等步骤编排给多个 agent,auto mode 让流程不必每一步都请求人工许可。
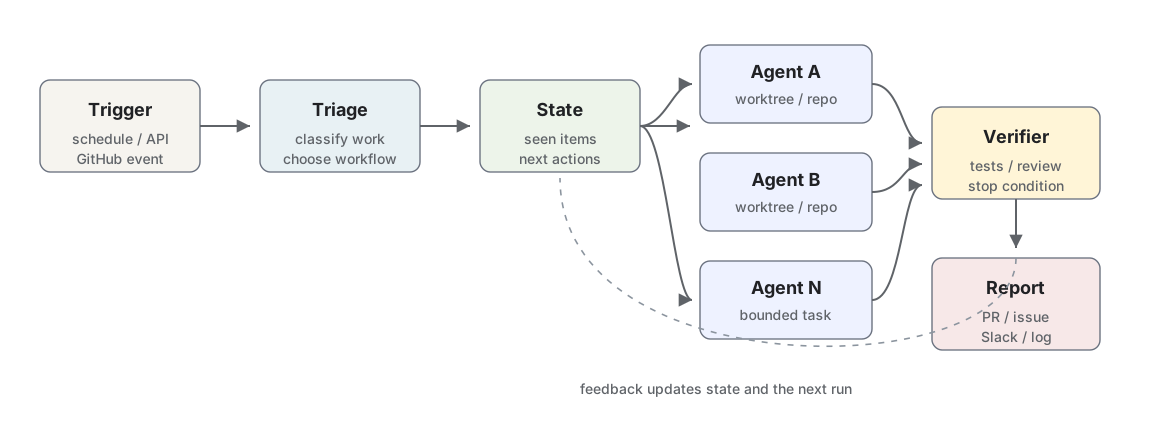
这类系统的关键不是“自动化程度更高”,而是“治理难度更高”。一旦无人实时介入,就必须提前设计:
- 哪些动作允许自动执行?
- 哪些判断必须用更强模型或人工介入?
- 如何避免重复处理同一个反馈?
- 如何审查改动质量?
- 如何限制 token 和并发 agent 数量?
- 如何记录状态,以便下一次运行知道已经做过什么?
cc官方建议把小模型用于路由和常规任务,把最强模型用于判断型任务。这反映出一个实用原则:proactive loop 的成本控制不只靠少跑几次,也靠把不同难度的判断分配给不同能力和价格的模型。
3 loop使用注意事项
(1) 系统环境很重要
这个系统环境我理解是agent运行的物理机器与目录 + 可用工具与权限 + 会话上下文生命周期 + 跨会话记忆 + 技能/Hook等。
loop 的输出质量不是单个 prompt 决定的,而是由整个系统决定的。Claude 会沿用代码库已有模式,所以代码库越干净,agent 越容易做出一致改动;文档越容易访问,agent 越少凭过时知识猜测;验证 skill 越具体,agent 越能自查;独立 reviewer 越常用,越能减少主 agent 被自己推理路径影响的偏差。最值得注意的是:当某个结果不达标时,不应该只修那个单点问题,而应该把教训编码进系统。这句话本质上是在说,agent 工作流的改进对象不是“这一次回答”,而是“下一次循环的环境”。如果某类错误反复出现,就该写成 skill、测试、脚本、workflow 或 review gate。
(2) 复杂 loop 必须有预算意识
CC把 token 管理拆成几个具体动作:
- 选择合适的原语和模型,不要让小任务承受多 agent 或长 loop 的开销。
- 定义明确成功和停止标准,让 agent 不会过早停,也不会无限继续。
- 大规模运行前先小范围 pilot,尤其是 dynamic workflows 可能生成大量 agent。
- 目前凭我这几次使用dynamic workflows 的经验来看,该功能还不成熟,尤其是cc经常会重复生成agent,而且有的时候某些agent不会返回结果,这会导致这个workflow一直卡在未返回结果的agent上,造成阻塞
- 对确定性工作用脚本,而不是每次让模型重新推理。
- 不要把 routine 跑得比外部变化更频繁。
- 用
/usage、/goal、/workflows等工具检查 token 消耗。
这里最有工程价值的是“脚本化确定性工作”。如果某件事步骤固定、输入输出明确,例如 PDF 表单填写、格式转换、批量检查,就应该写脚本让 agent 调用。模型负责判断和协调,脚本负责机械执行。这样既降低 token,又提高一致性。
(3) 停止条件比触发条件更重要
触发条件决定 loop 何时开始,停止条件决定风险是否可控。大多数失败来自停止条件不清楚:agent 可能提前交付半成品,也可能为了“更好”继续扩大范围。好的停止条件通常具备三个特征:
- 可观察:测试数、分数、CI 状态、队列长度、工单状态。
- 可判定:不是“更好一些”,而是“达到 X”或“没有 Y”。
- 有上限:最多轮数、最大时间、最大 token 或最大改动范围。
如果停止条件不可观察,evaluator 就只能猜。如果停止条件没有上限,loop 就很容易把一次任务变成无限探索。
4 Future
如果一个loop搭建的很烂,然后这个loop一直都是ai review,ai fix,这样会陷入恶性循环,这不是我们想要的,真正应该做的是构建loop之前规划好自己的workflow,对每个phase都由最了解的人去把关,这样最后的效果才可能达到预期。对于工程师来说,我们不能只做一键启动loop的人,而是对业务逻辑,整体workflow了如指掌的人。
换句话说,loop engineering 的重点不是让 agent 替你思考一切,而是把可重复的执行、可检查的验证和可追踪的状态设计好,让 agent 在这个系统里可靠地工作。
Credits
- Getting started with loops | Claude by Anthropic
- Loop Engineering | Addy Osmani
- How the agent loop works | Claude Code Docs
- Keep Claude working toward a goal | Claude Code Docs
- Run prompts on a schedule | Claude Code Docs
- Automate work with routines | Claude Code Docs
- 第12章:Loop Engineering —— 从提示 Agent 到设计循环 —— 《AI时代的软件工程》
- openai/codex-plugin-cc
Citation
Citation: When reposting or citing content from this article, please credit the original author and source.
Cited as:
Zachary WEI. (Jul 2026). Looping:从提示 Agent 到设计循环. https://zachary-ww.github.io/zh/posts/looping/
Or
@article{zachary2026-looping,
  title   = "{Looping:从提示 Agent 到设计循环}",
  author  = "Zachary WEI",
  journal = "zachary-ww.github.io",
  year    = "2026",
  month   = "Jul",
  url     = "https://zachary-ww.github.io/zh/posts/looping/"
}